اگر از همان ابتدا معماری نرمافزار را درست طراحی کنید با مشکلات کمتری در آینده روبرو خواهید شد.
این همان انعطافپذیری خاموش و قدرتمندی است که به زوم (Zoom) کمک کرد تا در دوران همهگیری کرونا، عصر جدیدی از کار از راه دور را رقم بزند.
اما اگر حتی یک جزئیات را فراموش کنید؟ ممکن است شاهد شکستهایی مانند آکتا (Okta) در سال ۲۰۲۳ باشید, جایی که ضعفهای معماری اجازه داد هکرها به جلسات مدیریتی دهها مشتری مختلف دسترسی پیدا کنند.
در این راهنمای جامع، مفاهیم کلیدی طراحی سیستم را از طریق تشبیه به یک قهوهفروشی آموزش بررسی میکنیم جایی که باریستا باید هم سیستم فروشگاه را مدیریت کند و هم مشتریانش را با قهوهای لذیذ راضی نگه دارد.
این محتوا برای مدیران محصول، دانشمندان داده، مهندسان یادگیری ماشین و هر متخصصی طراحی شده که در سال ۲۰۲۵ درگیر طراحی سیستمهای مقیاسپذیر است.
درک طراحی سیستم در سال ۲۰۲۵
هر روز مهندسان بااستعدادی را میبینیم که در الگوریتمها و ساختارهای داده تبحر دارند و کدهایی زیبا و بدون باگ مینویسند و این فوقالعاده است.
اما وقتی صحبت از ساخت سیستمهایی میشود که به میلیونها کاربر خدمات میدهند، با پتابایتها داده کار میکنند یا موتور محرکهٔ نسل بعدی هوش مصنوعی هستند، نیاز به مهارتهای کاملاً متفاوتی دارید.
و در سال ۲۰۲۵، این مهارتها کاملاً متفاوت از دههٔ گذشته هستند.
معماری Server Driven UI در فلاتر
طراحی سیستم چیست؟
طراحی سیستم، فرآیند درک نیازمندیهای یک سیستم و ساخت زیرساختی است که بتواند آنها را به بهترین شکل برآورده کند.
در عصر هوش مصنوعی، صرفاً یک برنامهنویس خوب بودن کافی نیست.
برای موفقیت واقعی در این صنعت، باید مهندسی باشید که میتواند معماری طراحی کند کسی که میداند چگونه اجزای حیاتی را به هم متصل کند، چگونه آنها را مقیاسپذیر نگه دارد و چگونه در شرایط بحرانی، سیستم را انعطافپذیر و مقاوم نگه دارد.
اگرچه بسیاری از الگوهای کلیدی طراحی سیستم همچنان معتبر و کاربردی هستند، اما طراحی سیستم امروزی در نقطهای قرار دارد که دو جریان قدرتمند روشهای بالغِ ابرِ بومی (Cloud-Native) و انفجار کاربردهای بومیِ هوش مصنوعی (AI-Native) به هم میرسند.
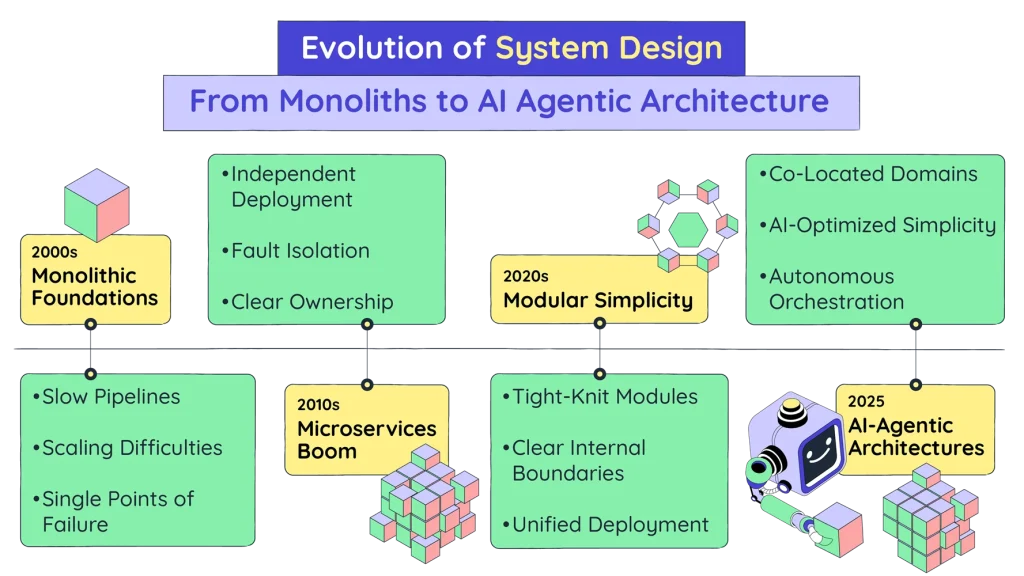
در این تقاطع، صرف مهارت کدنویسی دیگر کافی نیست؛ بلکه معماری هوشمندانه و آیندهنگر است که تیمها را به مقصد میرساند.
شرکتهایی مانند آمازون با معرفی گستردهٔ معماری سرویسمحور و زیرساختهای ابری از طریق AWS، و گوگل با ارائهٔ فناوریهایی چون MapReduce، Spanner و Kubernetes، استانداردهای جدیدی را تعیین کردند.
تأثیر ترکیبی این دو غول فناوری، صنعت را از سیستمهای یکپارچه و کندِ گذشته به سمت سرویسهایی ماژولار، مقیاسپذیر و خودتعمیرکننده سوق داد.
قدم بعدی در این مسیر با ظهور مدلهای زبانی بزرگ (LLM)، تولید تقویتشده با بازیابی (RAG) و عاملهای خودمختار رقم خواهد خورد.
هوش دیگر یک لایهٔ جانبی یا افزوده در حاشیهٔ سیستم نیست بلکه در مسیر اصلی پردازش درخواستها قرار گرفته و بهصورت بلادرنگ یاد میگیرد، استدلال میکند و خود را تطبیق میدهد.
این تحول، چالشهای جدیدی را به سه سؤال کلاسیکِ طراحی سیستم تأخیر (Latency)، در دسترس بودن (Availability) و توان عملیاتی (Throughput) اضافه کرده است:
- هر مؤلفه چگونه با تغییر دادهها (Data Drift) یاد خواهد گرفت و خود را تطبیق خواهد داد؟
- دانشِ بلادرنگ در کجا ذخیره میشود و چه کسی مسئول نگهداری و بهروزرسانی آن است؟
- جریان کنترل سیستم چگونه خواهد بود وقتی یک عامل خودمختار پیش از دریافت دستور انسانی اقدام میکند؟
- چگونه میتوان هزینهها را کنترل کرد، در حالی که هزینهٔ استنتاج مدلهای هوش مصنوعی بسیار بیشتر از سایر بخشهای سیستم است؟
با توجه به این زمینه، در ادامه به بررسی مفاهیم کلیدی میپردازیم که طراحی سیستمی هوشمندانه و مؤثر را تعریف میکنند.
مفاهیم پایهٔ طراحی سیستم
طراحی سیستم، ایدههای محصول را به سرویسهایی قابل اعتماد، مقیاسپذیر و پایدار تبدیل میکند.
چه مهندسی باشید که به دنبال کاهش تأخیر به میلیثانیه هستید، چه مدیر محصولی که نقشهراه تیم را هماهنگ میکنید، یا چه معماری که میخواهید پلتفرمی را برای آینده آماده کنید چند مفهوم کلیدی زیر همیشه و در همه جا تکرار میشوند.
این مفاهیم را میتوانید به عنوان بلوکهای سازندهٔ اساسی طراحی سیستم در نظر بگیرید.
در ادامه، هر مفهوم با یک تعریف ساده و روان، نکتهای کوتاه دربارهٔ مصالحههای مرتبط، و (در جای مناسب) یک تشبیه ساده از دنیای قهوهسازی اسپرسو ارائه میشود:
۱. راهبردهای ذخیرهسازی داده
۲. شَردینگ و پارتیشنبندی پایگاه داده
۳. تکرارپذیری و رپلیکیشن (Redundancy & Replication)
۴. توزیع بار (Load Balancing)
۵. کشینگ (Caching)
۶. شبکه تحویل محتوا (CDN)
۷. محدودیت نرخ و تِرُتلینگ (Rate Limiting & Throttling)
۸. پردازش ناهمزمان (Asynchronous Processing)
۹. قضیه CAP ۱۰. قضیه PACELC
۱. راهبردهای ذخیرهسازی داده
راهبردهای ذخیرهسازی داده تعیین میکنند که اطلاعات چگونه سازماندهی، دسترسی و مقیاسدهی شوند.
هنگام طراحی یک سیستم، مهندسان باید روش ذخیرهسازی را بر اساس ساختار داده، الگوهای پرسوجو، نیازهای تأخیر و الزامات سازگاری انتخاب کنند.
🔹 پایگاههای داده رابطهای مانند PostgreSQL یا MySQL معمولاً برای سیستمهای تراکنشی مناسباند که به سازگاری قوی و روابط ساختاریافته نیاز دارند.
🔹 در مقابل، پایگاههای NoSQL مانند Cassandra یا MongoDB برای برنامههایی که به نرخ نوشتن بالا، اسکیمای انعطافپذیر یا مقیاسپذیری افقی نیاز دارند، گزینهٔ بهتری هستند.
🔹 برنامههای ابری-بومی (Cloud-Native) اغلب از ذخیرهسازی شیءمحور مانند Amazon S3 برای مدیریت کارآمد فایلهای حجیم یا دادههای بدون ساختار استفاده میکنند.
فراتر از انتخاب نوع پایگاه داده، راهبردهای ذخیرهسازی باید رشد و عملکرد سیستم در مقیاس بزرگ را نیز در نظر بگیرند. این شامل تکنیکهایی مانند:
✅ ایندکسگذاری برای پرسوجوهای سریعتر
✅ بهینهسازی برای سیستمهای با ترافیک خواندنی یا نوشتنی سنگین
✅ استفاده از پایگاههای داده سریزمانی (Time-Series) برای دادههای تلهمتری
☕ تشبیه قهوهای:
دانههای قهوه در مخازن درببسته نگه داشته میشوند، پودر قهوه در پورتافیلتر، و شیر در ظرف سرد. اگر از ظرف اشتباه استفاده کنید، طراوت و کیفیت سریعاً از بین میرود.
۲. پارتیشنبندی و شَردینگ پایگاه داده
پارتیشنبندی و شَردینگ دو استراتژی کلیدی برای تقسیم مجموعهدادههای بزرگ به بخشهای کوچکتر و قابل مدیریتتر هستند با هدف بهبود عملکرد و مقیاسپذیری.
🔹 پارتیشنبندی (Partitioning)
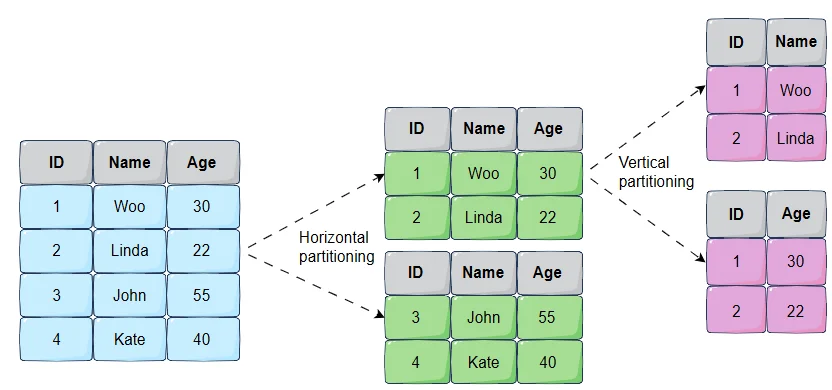
در پارتیشنبندی، دادهها در در داخل یک نمونه (instance) پایگاه داده تقسیم میشوند معمولاً بر اساس قوانین منطقی مانند محدوده تاریخ یا شناسه کاربر.
این کار باعث کاهش حجم دادهای میشود که هر پرسوجو باید اسکن کند و در نتیجه سرعت دسترسی و کارایی را افزایش میدهد.
پارتیشنبندی معمولاً در سطح پایگاه داده انجام میشود و برای منطق برنامه (Application Logic) شفاف است.
دو نوع اصلی پارتیشنبندی وجود دارد:
- افقی (Horizontal): تقسیم سطرها (مثلاً کاربران ۱ تا ۱۰۰۰ در پارتیشن اول، ۱۰۰۱ تا ۲۰۰۰ در پارتیشن دوم)
- عمودی (Vertical): تقسیم ستونها (مثلاً اطلاعات پروفایل کاربر در یک جدول، و تاریخچه خرید در جدول دیگر)
🔹 شَردینگ (Sharding)
در شَردینگ، دادهها در چندین نمونه یا سرور پایگاه داده مختلف توزیع میشوند و هر "شَرد" (Shard) زیرمجموعهای منحصربهفرد از دادهها را در خود نگه میدارد.
این روش برای سیستمهایی ضروری است که ظرفیت یک پایگاه داده واحد را پشت سر گذاشتهاند.
اما شَردینگ پیچیدگیهایی هم به همراه دارد:
- مسیریابی پرسوجوها به شَرد صحیح
- حفظ سازگاری دادهها
- انجام عملیات JOIN بین شَردها
طراحی کلید شَردینگ (Shard Key) بسیار حیاتی است. انتخاب ضعیف میتواند منجر به نقطههای داغ (Hotspots) یا توزیع نامتوازن دادهها شود.
در عوض، شَردینگ امکان مقیاسپذیری افقی را در سیستمهای بزرگ فراهم میکند و به سیستم اجازه میدهد بدون دردسر با رشد کاربران و حجم دادهها همگام شود.
☕ تشبیه قهوهای:
سفارشها را بین دو ایستگاه اسپرسو تقسیم کنید: باریستای A سفارشهای با شماره فرد را میپزد، باریستای B سفارشهای زوج را. نوشیدنیها سریعتر تحویل داده میشوند اما حالا باید سطح دانههای قهوه و زمان پخت اسپرسو را در هر دو پult رویت کنید!
۳. تکرارپذیری و رپلیکیشن (Redundancy & Replication)
🔹 تکرارپذیری (Redundancy)
تکرارپذیری به معنای دوبارهسازی مؤلفههای حیاتی سیستم برای بهبود قابلیت اطمینان، در دسترس بودن و تحمل خطا است.
با قرار دادن نسخههای پشتیبان یا نمونههای جایگزین، سیستم دیگر نقطه شکست واحد (Single Point of Failure) نخواهد داشت و حتی در صورت خرابی یک بخش، به کار خود ادامه میدهد.
مثال: اجرای چندین نمونه از یک سرویس روی ماشینهای یا مناطق جغرافیایی مختلف در صورت خرابی یک نمونه، ترافیک بهصورت خودکار به نمونههای سالم هدایت میشود.
این امر زمان در دسترس بودن (Uptime) و تجربه کاربری را بهطور چشمگیری بهبود میبخشد.
🔹 رپلیکیشن (Replication)
رپلیکیشن همراه با تکرارپذیری کار میکند و وظیفه دارد نسخههای تکراری را همگام نگه دارد.
این امر تضمین میکند که داده یا وضعیت سیستم در تمام منابع تکراری، سازگار باقی بماند.
در پایگاههای داده، رپلیکیشن معمولاً با مدل اصلی-تکرار (Primary-Replica) پیادهسازی میشود:
- گره اصلی (Primary): تمام عملیات نوشتن (Write) را پردازش میکند.
- گرههای تکرار (Replica): تغییرات را در زمانی نزدیک به واقعی دریافت و اعمال میکنند.
- این معماری علاوه بر بهبود مقیاسپذیری خواندن (Read Scalability)، از بازیابی پس از بلایا (Disaster Recovery) پشتیبانی کرده و انعطافپذیری کلی سیستم را افزایش میدهد.
همچنین میتوان رپلیکیشن را بین مناطق جغرافیایی مختلف گسترش داد تا تأخیر (Latency) کاهش یابد و در صورت قطعی منطقهای، سیستم همچنان در دسترس باشد.
۴. توزیع بار (Load Balancing)
توزیع بار فرآیند هدایت و پخش ترافیک ورودی بین چندین سرور است با هدف جلوگیری از اینکه یک سرور واحد تبدیل به گلوگاه عملکردی شود.
توزیعکنندههای بار (Load Balancers) با توزیع یکنواخت بار کاری، پاسخگویی سیستم را بهبود میبخشند و قابلیت اطمینان کلی را افزایش میدهند.
این امر به برنامهها اجازه میدهد تا هزاران کاربر همزمان را بدون کاهش عملکرد پشتیبانی کنند.
چه به صورت سختافزاری و چه نرمافزاری پیادهسازی شوند، توزیعکنندههای بار معمولاً بین کلاینتها و سرورهای بکاند قرار میگیرند.
هر درخواست ورودی بر اساس الگوریتمهای از پیش تعریفشده مانند Round-Robin، کمترین اتصالهای فعال یا زمان پاسخ سرور به یکی از سرورها هدایت میشود.
همچنین، توزیعکنندههای بار بهطور مداوم وضعیت سلامت سرورها را بررسی میکنند و در صورت شناسایی سرورهای غیرفعال یا کند، ترافیک را بهصورت خودکار به سرورهای سالم منتقل مینمایند.
این ویژگیها به حفظ در دسترس بودن بالا، جلوگیری از قطعی سرویس و پشتیبانی از مقیاسپذیری افقی در معماریهای توزیعشده کمک میکنند.
☕ تشبیه قهوهای:
سرپرست قهوهفروشی هر سفارش را به ماشین اسپرسویی که کوتاهترین صف را دارد هدایت میکند.
اگر یکی از ماشینها دچار مشکل شود، سفارشها به سایر ماشینها منتقل میشوند.
صفها کوتاه میمانند، قهوه گرم است و فشار بین ایستگاهها بهخوبی توزیع شده است.
پیاده سازی معماری تمیز در برنامه نویسی فلاتر
۵. کشینگ (Caching)
کشینگ تکنیکی است که دادههای پرکاربرد یا نتایج محاسباتی را در یک فضای ذخیرهسازی موقت و با سرعت بالا به نام «کَش» نگه میدارد.
هدف اصلی کشینگ، کاهش نیاز به بازمحاسبه یا بازیابی مجدد دادهها از منابع کندتر یا دورتر (مانند پایگاه داده یا سرورهای ریموت) است.
وقتی برنامهای به داده خاصی نیاز دارد، ابتدا در کَش جستجو میکند.
اگر داده در کَش یافت شود، تقریباً فوراً در دسترس قرار میگیرد.
اگر نباشد، داده از منبع اصلی بازیابی، پردازش و اغلب برای دسترسی سریعتر در آینده در کَش ذخیره میشود.
این فرآیند بهطور چشمگیری عملکرد سیستم را بهبود میبخشد: تأخیر کاهش مییابد، بار روی منابع اصلی کم میشود و در نتیجه زمان پاسخ سریعتر و استفاده بهینهتر از منابع حاصل میشود.
☕ تشبیه قهوهای:
باریستا یک قوری قهوهٔ فیلتری آماده میکند و آن را در یک کاراف ترموسی نگه میدارد.
وقتی کسی همان قهوهٔ معمول را سفارش میدهد، باریستا مستقیماً از کاراف (کَش) سرو میکند نه اینکه دوباره قهوه بپزد.
این کار زمان انتظار را کاهش میدهد و فشار روی ماشین اسپرسو را کم میکند.
۶. شبکه تحویل محتوا (CDN)
شبکه تحویل محتوا (CDN) یک شبکهٔ جهانی از سرورهای توزیعشده است که با همکاری یکدیگر، محتوای وب، رسانهها و سایر داراییهای دیجیتال را بر اساس موقعیت جغرافیایی کاربر تحویل میدهند.
هدف اصلی CDN کاهش تأخیر (Latency) و بهبود عملکرد است با این که محتوا از سروری که نزدیکترین فاصله فیزیکی را به کاربر دارد، ارائه شود.
وقتی کاربری درخواستی مانند بارگذاری یک صفحه وب، تصویر یا ویدیو میکند، CDN ابتدا بررسی میکند که آیا آن محتوا در سرور لبه (Edge Server) نزدیک به کاربر کَش شده است یا خیر.
اگر بله، محتوا فوراً تحویل داده میشود.
اگر نه، سرور لبه محتوا را از سرور اصلی (Origin Server) دریافت کرده، یک نسخه محلی از آن را ذخیره میکند و سپس به کاربر تحویل میدهد.
این مکانیسم کَش، نیاز به درخواستهای مکرر به سرور مرکزی را کاهش میدهد نتیجه: زمان پاسخ کوتاهتر و بار کمتر روی زیرساخت بکاند.
همچنین، CDNها در دسترس بودن و تحمل خطا را با هدایت خودکار درخواستها به سرورهای سالم و توزیع ترافیک بین چندین گره بهبود میبخشند.
این فناوری نقشی حیاتی در طراحی سیستمهای مدرن ایفا میکند بهویژه برای برنامههای پرترافیک که سرعت، مقیاسپذیری و دسترسی جهانی برایشان حیاتی است.
☕ تشبیه قهوهای:
به جای اینکه همه مشتریان را به یک کارخانه برشتهکنی در مرکز شهر بفرستید، دانههای قهوه را در کافههای منطقهای ذخیره کنید خدمترسانی سریعتر، پایدارتر و در دسترستر خواهد بود.
۷. محدودیت نرخ و تِرُتلینگ (Rate Limiting & Throttling)
محدودیت نرخ (Rate Limiting) مکانیسمی است که تعداد درخواستهایی که یک کاربر یا کلاینت میتواند در یک بازه زمانی مشخص به یک سرویس ارسال کند را محدود میکند.
این کار از سوءاستفاده جلوگیری میکند، استفاده منصفانه از منابع را تضمین مینماید و سیستم را در برابر افزایش ناگهانی ترافیک یا حملات مخرب محافظت میکند.
مثلاً یک API ممکن است تنها اجازهٔ ۱۰۰ درخواست در دقیقه را به هر کاربر بدهد در صورت تجاوز، درخواستهای اضافی با پیام خطای مناسبی رد میشوند.
محدودیت نرخ مؤثر، پایداری سیستم را بهبود میبخشد، به حفظ عملکرد یکنواخت کمک میکند و از سرویسهای بکاند در برابر بار بیشازحد محافظت مینماید.
این مکانیسم معمولاً در سطح درگاه API یا توزیعکننده بار پیادهسازی میشود و از الگوریتمهایی مانند:
- پنجره ثابت (Fixed Window)
- پنجره لغزان (Sliding Window)
- سطل توکن (Token Bucket)
- سطل سوراخدار (Leaky Bucket)
استفاده میکند.
☕ تشبیه قهوهای:
باریستا با ادب از مشتریانی که سفارش عمده دارند میخواهد تا صف کمی خلوتتر شود صبر کنند این کار از بار بیشازحد روی آسیاب قهوه جلوگیری میکند.
ملاحظات ضروری در طراحی سیستم
اکنون که با بلوکهای سازندهٔ اساسی طراحی سیستم آشنا شدید، نوبت آن است که یک قدم فراتر بگذاریم.
ملاحظات ضروری طراحی سیستم، اصولی هستند که نحوهٔ ساختاردهی و توسعهٔ یک سیستم را هدایت میکنند.
این اصول تضمین میکنند که سیستم بتواند:
✅ با رشد مقیاسپذیر بماند
✅ تجربهای نرم و بدون وقفه به کاربران ارائه دهد
✅ پس از خطاها بهسرعت بازیابی شود
✅ در برابر تغییرات آینده انعطافپذیر باقی بماند
نادیده گرفتن این ملاحظات، منجر به سیستمهایی شکننده و ناپایدار میشود.
سیستمهایی که تحت فشار ترافیک دچار خرابی میشوند، هزینههای بالایی دارند یا بهسختی قابل توسعه و ارتقا هستند.
در اصطلاحات طراحی سیستم، این ملاحظات اغلب به عنوان نیازمندیهای غیرعملکردی (Non-Functional Requirements) شناخته میشوند یعنی ویژگیهایی که مشخص میکنند سیستم «چگونه» باید کار کند، نه «چه کاری» باید انجام دهد.
برخی از مهمترین ملاحظات طراحی سیستم عبارتند از:
🔹 مقیاسپذیری (Scalability)
🔹 قابلیت اطمینان (Reliability)
🔹 در دسترس بودن (Availability)
🔹 عملکرد (Performance)
🔹 امنیت و احراز هویت (Security & Authentication)
۱. مقیاسپذیری (Scalability)
مقیاسپذیری به توانایی سیستم در پاسخگویی به افزایش تقاضا بدون کاهش کیفیت خدمات اشاره دارد. یک سیستم مقیاسپذیر باید بتواند با رشد کاربران، حجم دادهها یا تعداد درخواستها، بهصورت کارآمد و بدون نیاز به بازنویسی کامل، همگام شود.
دو نوع اصلی مقیاسپذیری وجود دارد:
✅ مقیاسپذیری افقی (Horizontal Scaling)
افزایش تعداد نودها یا سرورها مثلاً اضافه کردن سرورهای جدید به خوشه (Cluster).
این روش معمولاً منعطفتر و مقرونبهصرفهتر است و برای سیستمهای مدرن و ابری ایدهآل محسوب میشود.
✅ مقیاسپذیری عمودی (Vertical Scaling)
ارتقای منابع یک سرور موجود مثلاً افزایش RAM، CPU یا ذخیرهسازی.
این روش سادهتر است اما سقف محدودی دارد و در صورت خرابی سرور، نقطه شکست واحد ایجاد میکند.
🔧 نکات کلیدی برای طراحی مقیاسپذیر:
- استفاده از معماری بدون حالت (Stateless) برای سرویسها
- پیادهسازی بارگذاری متعادل (Load Balancing)
- طراحی صحیح شَردینگ و پارتیشنبندی دادهها
- استفاده از کش و CDN برای کاهش فشار روی منابع اصلی
- امکان افزودن یا کاهش منابع بهصورت پویا (Auto-scaling)
۲. قابلیت اطمینان (Reliability)
قابلیت اطمینان به توانایی یک سیستم در انجام پیوسته و بدون خطا وظایف مورد انتظارش در طول زمان اشاره دارد. این ویژگی تضمین میکند که کاربران بتوانند حتی در شرایط نامطلوب، به سیستم اعتماد کنند و انتظار عملکرد صحیح از آن داشته باشند.
به عنوان مثال، یک سرویس ذخیرهسازی فایل ابری مانند Google Drive باید بهطور قابل اعتمادی فایلهای کاربران را ذخیره و بازیابی کند بدون از دست دادن داده، خرابی فایل یا قطعیهای غیرمنتظره.
☕ تشبیه قهوهای:
ماشین اسپرسو بین هر شیفت، بهصورت خودکار سیستم خود را پاکسازی و فشار را بررسی میکند بنابراین هر فنجان قهوه، چه ساعت ۶ صبح دوشنبه و چه ۹ شب جمعه، طعم یکسانی دارد.
۳. در دسترس بودن (Availability)
در دسترس بودن معیاری است که نشان میدهد سیستم چقدر آمادهٔ استفاده و قابل دسترسی است یعنی در چه درصدی از زمان، سیستم بهدرستی پاسخگو است.
مثلاً یک سیستم بانکداری آنلاین باید ۲۴ ساعته و هفت روز هفته در دسترس باشد تا مشتریان بتوانند هر زمان که نیاز داشتند، موجودی خود را بررسی کنند، وجه منتقل کنند یا پرداخت انجام دهند.
دستیابی به در دسترس بودن بالا مستلزم استفاده از تکرارپذیری (Redundancy) مانند اجرای چندین نمونه از سرویسها و رپلیکیشن دادهها برای حذف نقاط شکست واحد است.
همچنین، پیادهسازی استراتژیهای Failover و بررسیهای سلامت مداوم امکان شناسایی سریع و جایگزینی مؤلفههای معیوب را فراهم میکند و زمان قطعی (Downtime) را به حداقل میرساند.
🔍 تفاوت کلیدی: قابلیت اطمینان vs. در دسترس بودن
بسیاری این دو مفهوم را با هم اشتباه میگیرند، اما هر کدام جنبهٔ متفاوتی از عملکرد سیستم را اندازهگیری میکنند:
- قابلیت اطمینان (Reliability): چقدر طول میکشد تا سیستم دچار خطا شود؟ (مثلاً میانگین زمان بین خرابیها MTBF)
- در دسترس بودن (Availability): چقدر از زمان، سیستم قابل استفاده است؟ (مثلاً ۹۹.۹% در دسترس بودن)
💡 یک سیستم میتواند قابل اعتماد باشد (خیلی کم خراب میشود) اما در دسترسی پایین داشته باشد — مثلاً اگر زمان بازیابی یا تعمیرات پس از خرابی، بسیار طولانی باشد.
۴. عملکرد (Performance)
عملکرد به سرعت و کارایی پاسخگویی یک سیستم به درخواستهای کاربر و پردازش دادهها اشاره دارد.
به عنوان مثال، یک سرویس استریم ویدیو باید حتی در اوج ترافیک، پخش روان و بدون بافرینگ را تضمین کند.
🛠️ تکنیکهای بهبود عملکرد:
- کشینگ: با ذخیرهسازی دادههای پرکاربرد نزدیک به کاربر، تأخیر (Latency) را کاهش میدهد.
- توزیع بار (Load Balancing): ترافیک را بهصورت بهینه بین سرورها پخش میکند تا از منابع بهخوبی استفاده شود.
- پردازش ناهمزمان (Asynchronous Processing): برای وظایف سنگین، پاسخگویی رابط کاربری را حفظ میکند بدون مسدود کردن تجربه کاربر.
☕ تشبیه قهوهای:
تابلوی دیجیتال سفارشها را دقیقاً در لحظهٔ ثبت، روشن میکند باریستاها بلافاصله سراغ سفارش بعدی میروند، بدون اینکه مجبور باشند به دنبال کاغذچههای دستنویس بگردند.
این کار چند ثانیه از زمان هر فنجان کم میکند و صف را همیشه در حرکت نگه میدارد.
۵. امنیت و احراز هویت (Security & Authentication)
امنیت در طراحی سیستم به معنای محافظت از سیستمها و دادهها در برابر دسترسی غیرمجاز، سوءاستفاده و تهدیدات سایبری است.
این موضوع بهویژه در برنامههایی که با دادههای حساس کار میکنند مانند پلتفرمهای تجارت الکترونیک حیاتی است.
مثلاً یک فروشگاه آنلاین باید اطلاعات پرداخت، مشخصات شخصی و سوابق تراکنش کاربران را محافظت کند تا از نشت اطلاعات و کلاهبرداری جلوگیری شود.
بدون اقدامات امنیتی قوی، حتی یک سیستم با معماری عالی میتواند به یک مسئولیت سنگین تبدیل شود.
استراتژیهای مدرن امنیتی:
- دفاع در عمق (Defense in Depth): لایهبندی حفاظت در سطوح مختلف شبکه، برنامه و داده.
- احراز هویت (Authentication): تأیید هویت کاربر — بهترین روش: احراز هویت چندعاملی (MFA) برای کاهش خطر دسترسی غیرمجاز.
- مجوزدهی (Authorization): اطمینان از اینکه کاربران و سرویسها فقط به منابعی دسترسی دارند که اجازهٔ قانونی استفاده از آنها را دارند بر اساس اصل کمترین دسترسی (Least Privilege).
- رمزنگاری در حال انتقال (TLS/SSL) و رمزنگاری در حالت سکون (AES): محافظت از دادهها هم در مسیر انتقال و هم در زمان ذخیرهسازی.
- درگاههای API امن، چرخش منظم اعتبارنامهها، ثبت رویدادهای امنیتی و حسابرسیهای دورهای: برای حفظ یک معماری امن و انعطافپذیر.
☕ نیازمندیهای عملکردی: ویژگیهای دستگاه قهوهساز شما
این نیازمندیها دقیقاً مشخص میکنند که دستگاه قهوهساز چه کارهایی باید انجام دهد تا انتظارات کاربر را برآورده کند مثل ویژگیهای پایه:
- دم کردن قهوه با فشار دکمه: شما دکمه را میزنید، قهوه بهصورت قابل اعتماد ظاهر میشود.
- انتخاب نوع قهوه: اسپرسو، فیلتری، کاپوچینو گزینههایی دقیقاً متناسب با سلیقه کاربر.
- تنظیم غلظت قهوه: چه دوست داشته باشید ملایم باشد، چه قوی دستگاه باید پاسخگو باشد.
- تخلیه آب داغ یا بخار: فراتر از قهوه، نیازهای دیگری مثل دم کردن چای یا بخار دادن شیر را نیز برآورده کند.
این مؤلفههای عملکردی، تعامل مستقیم با کاربر را شکل میدهند و تواناییهای اصلی را تعریف میکنند که بدون آنها، دستگاه نمیتواند وظیفه اصلی خود را انجام دهد.
نیازمندیهای غیرعملکردی: چگونگی اجرای عملکردها
این نیازمندیها مشخص میکنند که دستگاه چقدر خوب وظایفش را انجام میدهد کیفیت، رضایت بلندمدت و تجربه کلی کاربر را شکل میدهند:
- عملکرد (زمان دم کردن سریع): کسی نمیخواهد برای قهوهاش زیاد منتظر بماند. سرعت دستگاه، رضایت کاربر را مستقیماً تحت تأثیر قرار میدهد.
- قابلیت اطمینان (دما ثابت): دستگاه باید همیشه قهوه را در دمای بهینه تحویل دهد تا کیفیت هر فنجان یکسان باشد.
- قابلیت نگهداری (شستوشو و نگهداری آسان): نگهداری منظم و بدون دردسر، دستگاه را در شرایط خوب نگه میدارد و از اختلال جلوگیری میکند.
- تجربه کاربری (کارکرد بیصدا): دستگاه پرنویز میتواند محیط را مختل کند بهویژه در فضاهای مشترک، سکوت حیاتی است.
- مقیاسپذیری و انعطافپذیری (صرفهجویی در انرژی و دوام): مصرف انرژی بهینه و ساختار بادوام، تضمین میکند که دستگاه حتی تحت استفاده سنگین، سالها عملکرد خوبی داشته باشد.
این ویژگیهای غیرعملکردی تعیین نمیکنند که دستگاه چه کاری انجام میدهد، اما بهشدت روی اینکه چقدر رضایتبخش و قابل استفاده است تأثیر میگذارند و در نهایت، وفاداری کاربر و اعتبار برند را شکل میدهند.
با درک عمیق از این ملاحظات کلیدی، وقت آن است که به بررسی انواع مختلف طراحی سیستم بپردازیم معماریهایی که نحوهٔ ساختاردهی سیستمها را بر اساس مقیاس، پیچیدگی و هدف آنها هدایت میکنند.
فصل چهارم: انواع طراحی سیستم
اکنون که با مولفههای اصلی و ملاحظات ضروری طراحی سیستم آشنا شدید، نوبت آن است که به بررسی انواع مختلف طراحی سیستم بپردازیم.
کسی که سالها در شرکتهای بزرگ فناوری (MAANG) در ساخت و مقیاسدهی سیستمها تجربه داشته باشد، میداند که تسلط واقعی بر این حوزه مستلزم درک دیدگاهها و انواع مختلف طراحی است طراحیهایی که به شما کمک میکنند سیستمی مقاوم، قابل اعتماد و پایدار بسازید. این انواع را میتوان به دو دستهٔ کلی تقسیم کرد:
۱. سبکهای معماری (Architectural Styles)
طرحهای بنیادینی که نحوهٔ ساختاردهی و تعامل مؤلفههای سیستم را تعیین میکنند مانند معماری یکپارچه (Monolithic)، میکروسرویس (Microservices) و مبتنی بر رویداد (Event-Driven).
۲. طراحی سیستم حوزهمحور (Domain-Specific System Design)
رویکردهای طراحی که برای نیازهای خاص یک حوزه یا صنعت سفارشیسازی شدهاند مانند طراحی سیستم برای فرانتاند، طراحی سیستم برای هوش مصنوعی تولیدی (Generative AI) و غیره.
۱. سبکهای معماری
سبکهای معماری، طرح کلی و بنیادین سیستم را تعیین میکنند از نحوهٔ ساختار مؤلفهها گرفته تا نحوهٔ تعامل آنها و در نهایت تأثیر مستقیم بر مقیاسپذیری، قابلیت نگهداری و عملکرد سیستم.
انتخاب درست، پایهای محکم میسازد؛ انتخاب اشتباه، مانند ساختن خانه روی شنهای روان است.
معماری یکپارچه (Monolithic Architecture)
بسیاری از برنامهها از اینجا شروع میشوند: یک واحد واحد و یکپارچه که تمام مؤلفهها در آن بهصورت محکم به هم متصل بوده و در یک فرآیند اجرا میشوند.
این معماری در مراحل اولیه بهویژه برای استارتآپها یا پروژههایی با دامنهٔ محدود و مشخص بسیار کارآمد است.
✅ مزیت: توسعه سریع، استقرار ساده
معماری میکروسرویس (Microservices Architecture)
در این مدل، سیستم به مجموعهای از سرویسهای مستقل، کماتصال و قابل استقرار جداگانه تقسیم میشود هر کدام مسئول یک عملکرد تجاری خاص هستند.
✅ مزایا: مقیاسپذیری بالا، انعطافپذیری، استقلال تیمها
⚠️ چالشها: ارتباط بین سرویسها، حفظ سازگاری دادهها، پیچیدگی عملیاتی بیشتر
معماری مبتنی بر رویداد (Event-Driven Architecture)
این معماری بر پایهٔ تولید، تشخیص و مصرف رویدادها کار میکند تا تعامل بین مؤلفههای غیرمتصل را مدیریت کند.
✅ ایدهآل برای: سیستمهایی که نیاز به پاسخدهی بلادرنگ یا گردشکارهای ناهمزمان دارند مانند پردازش پرداخت یا سیستمهای اعلان.
⚠️ نیازمند طراحی دقیق برای: مدیریت جریان رویدادها، تضمین تحویل و عیبیابی
معماری بدون سرور (Serverless Architecture)
در این مدل، توسعهدهندگان برنامهها را میسازند و استقرار میدهند بدون مدیریت زیرساخت سرور.
ارائهدهندگان ابری منابع را بهصورت پویا و بر اساس میزان استفاده تخصیص میدهند تیمها میتوانند کاملاً روی منطق کسبوکار تمرکز کنند.
✅ مزایا: مقیاسپذیری خودکار، بهینهسازی هزینه
⚠️ محدودیتها: زمان اجرای محدود، وابستگی به ارائهدهنده (Vendor Lock-in)، تأخیر راهاندازی اولیه (Cold Start)
۲. طراحی سیستم حوزهمحور (Domain-Specific System Design)
اگر سبکهای معماری را اسکلت و سطوح طراحی را آناتومی سیستم در نظر بگیریم، تسلط واقعی زمانی حاصل میشود که بتوانید نیازهای خاص هر حوزهٔ کاربردی را درک کنید.
هر حوزه چالشهای منحصربهفردی دارد و نیازمند بهکارگیری تخصصی اصول طراحی است.
در ادامه، چند نمونه از مهمترین حوزههای طراحی سیستم را بررسی میکنیم:
طراحی سیستم فرانتاند (Frontend System Design)
این حوزه بر سمت کلاینت متمرکز است یعنی هر آنچه کاربر مستقیماً در مرورگر یا اپلیکیشن موبایل میبیند و با آن تعامل دارد.
در فضای رقابتی امروز، تجربه کاربری (UX) اولویت اول است. طراحی باید بر موارد زیر تأکید کند:
✅ تجربه کاربری شهودی و روان
✅ عملکرد بالا و سرعت بارگذاری سریع
✅ مدیریت کارآمد حالت (State Management) مانند Redux یا Zustand
✅ ساخت مؤلفههای UI قابل استفاده مجدد (Reusable Components)
✅ دسترسپذیری (Accessibility) و سازگاری بینقص با تمام مرورگرها اینها گزینههای اختیاری نیستند!
طراحی سیستم بکاند (Backend System Design)
بکاند، اتاق موتور هر برنامهٔ مدرن است شامل زیرساخت سمت سرور، منطق کسبوکار، پایگاههای داده و APIهایی که فرانتاند را تغذیه میکنند.
اینجاست که کارهای سنگین انجام میشود و تصمیمات حیاتی در مورد موارد زیر گرفته میشود:
✅ مدلسازی و ذخیرهسازی داده (SQL/NoSQL)
✅ طراحی APIهای مقاوم (REST, GraphQL)
✅ پیادهسازی منطق کسبوکار پیچیده
✅ مدیریت همزمانی و پردازش درخواستها در مقیاس بزرگ
✅ احراز هویت، مجوزدهی و امنیت دادهها بهصورت «ضد نفوذ»
طراحی سیستم هوش مصنوعی تولیدی (Generative AI System Design)
این حوزه، پیشرفتهترین لبهٔ طراحی سیستم امروز است جایی که برنامهها برای ادغام و استفاده از مدلهای هوش مصنوعی پیشرفته طراحی میشوند تا محتوایی مانند متن، تصویر، صوت یا ویدیو تولید کنند.
طراحی در این حوزه نیازمند:
✅ زیرساخت تخصصی برای اجرای و مقیاسدهی مدلهای بزرگ (LLM)
✅ خطوط لولهٔ دادهٔ قدرتمند برای آموزش و استنتاج
✅ مدیریت چالشهای تأخیر (Latency)، هزینه (Cost) و پیامدهای اخلاقی
✅ معماریهایی برای RAG (Retrieval-Augmented Generation)، Fine-tuning و مدیریت Context
درک اینکه چگونه اصول طراحی سیستم در دنیای واقعی و در مقیاس بزرگ به کار گرفته میشوند، به شما کمک میکند تا:
- بهترین روشهای عملی روز را بشناسید.
- با ترندهای جاری طراحی سیستم آشنا شوید.
- بین «تئوری» و «اجرای موفق» پل بزنید.
دیدگاهها (0)
دیدگاه خود را بنویسید